HammerHAI AI-Ready Data Engineering unterstützt Unternehmen und Forschungsprojekte dabei, bestehende Datensätze in hochwertige, KI-geeignete Daten umzuwandeln. Mithilfe sicherer, KI-gestützter Pipelines, die speziell auf Fertigungs- und Ingenieurdaten ausgerichtet sind, verbessert der Dienst die Metadatenqualität, ergänzt semantische Beschreibungen und bereitet Datensätze automatisiert für Machine-Learning-Anwendungen auf.
Zielgruppen
- Unternehmen aus Fertigung und Maschinenbau, die Qualität, Nutzbarkeit und KI-Eignung ihrer bestehenden Daten verbessern möchten
- Forschungs- und Innovationsprojekte mit Anforderungen an standardisierte Metadaten und reproduzierbare Datenaufbereitung
- KI-Entwickler:innen und Data Scientists, die Datenvorverarbeitung automatisieren und die Eignung von Datensätzen für Machine Learning bewerten möchten
- Data Stewards, die für Metadatenqualität, Interoperabilität und Datendokumentation verantwortlich sind
Beschreibung
Die Vorbereitung von Daten für KI-Anwendungen erfordert häufig erheblichen manuellen Aufwand. Industrielle Datensätze verfügen oft über unvollständige Metadaten, uneinheitliche Strukturen oder müssen vor dem Einsatz für Machine Learning aufwendig aufbereitet werden. Mangelhafte Metadaten erschweren zudem die Auffindbarkeit, das Verständnis und die Wiederverwendung von Daten.
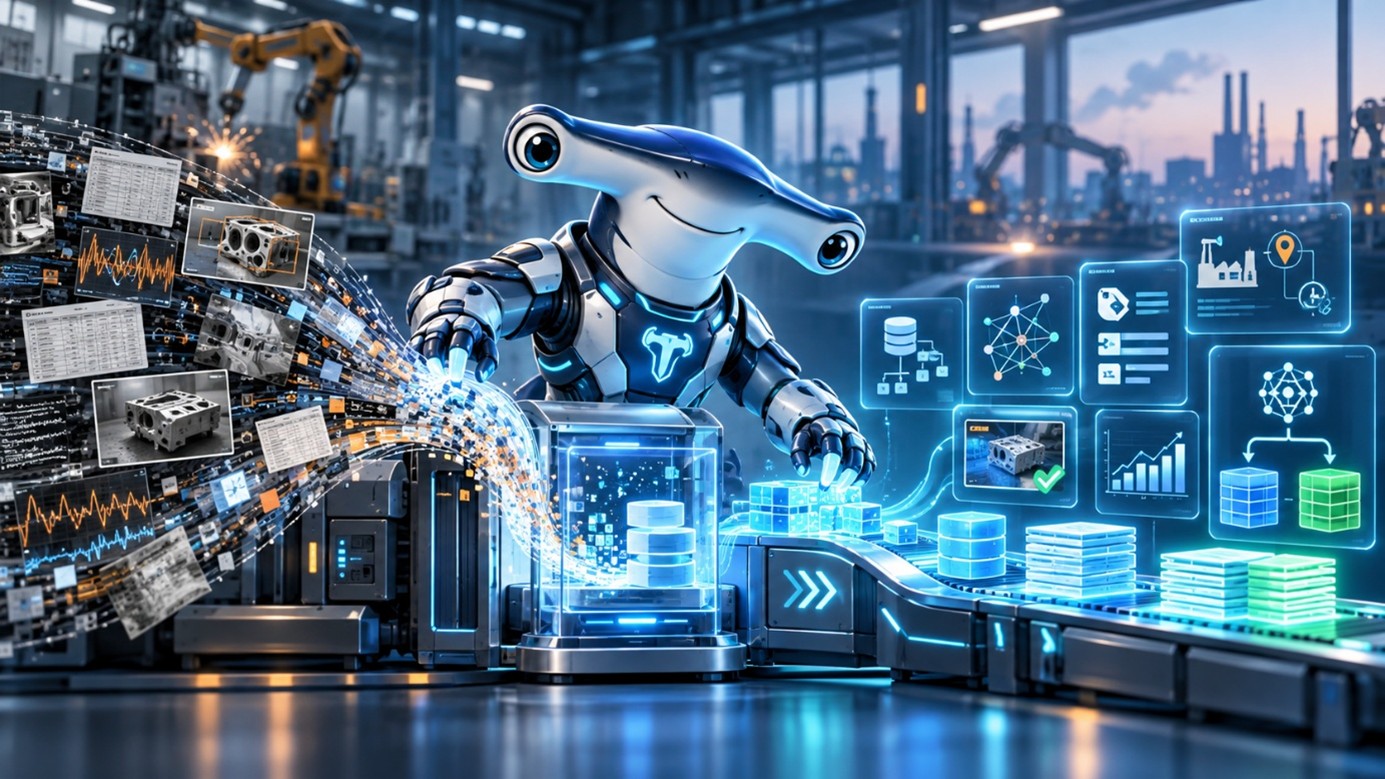
HammerHAI AI-Ready Data Engineering begegnet diesen Herausforderungen durch automatisierte, agentenbasierte Datenverarbeitungspipelines. Kern des Dienstes ist der am Karlsruher Institut für Technologie entwickelte Agentic Data Engineer, der KI-Agenten einsetzt, um Datensätze zu analysieren, geeignete Vorverarbeitungsschritte zu identifizieren und reproduzierbare, für Machine Learning geeignete Ergebnisse zu erzeugen.
Die Pipelines sind speziell auf Anwendungen in Fertigung und Ingenieurwesen ausgerichtet und entsprechen damit dem Schwerpunkt von HammerHAI auf industrieller KI. Sie berücksichtigen die Besonderheiten industrieller Daten, darunter Maschinen- und Sensormessungen, Produktionsdaten und Qualitätsdaten, um deren Einsatz für Predictive Maintenance, Fehlererkennung und weitere technische Anwendungen zu erleichtern.
Ein besonderer Schwerpunkt liegt auf Metadatenqualität, semantischer Interoperabilität und Datenherkunft (Provenance). Der Dienst ergänzt den HammerHAI Data Management Denst durch die Validierung und Anreicherung von Datensatzbeschreibungen anhand von Standards wie DCAT. Dadurch werden Datensätze leichter auffindbar, verständlich und projektübergreifend wiederverwendbar.
Darüber hinaus untersuchen die Pipelines die Eignung von Datensätzen für unterschiedliche KI-Vorhersageaufgaben, erzeugen wiederverwendbare Datentransformationen und erstellen geeignete Trainings- und Testdatensätze unter Berücksichtigung möglicher Datenlecks (Data Leakage). Die Ergebnisse werden im Format MLCommons Croissant einschließlich maschinenlesbarer Metadaten und Herkunftsinformationen dokumentiert.
Der Dienst unterstützt die Verarbeitung privater Datensätze in kontrollierten Umgebungen. Agentenbasierte Workflows können SAIA-LLM-Dienste nutzen und Datentransformationen in abgeschotteten Ausführungsumgebungen (Sandboxes) durchführen. Dadurch wird der Zugriff auf sensible Informationen begrenzt und das Risiko von Prompt-Injection-Angriffen oder unberechtigten Datenzugriffen reduziert. Strukturierte Metadaten, die Dokumentation der Datenherkunft und reproduzierbare Prozesse unterstützen zudem KI-Governance und Datenmanagementpraktiken im Sinne von ISO/IEC 42001.
Das HammerHAI AI-Ready Data Engineering bietet folgende Funktionen:
Metadatenqualität und semantische Anreicherung
- Vollständigkeit, Konsistenz und Qualität von Datensatzmetadaten analysieren und verbessern.
- Standardisierte semantische Beschreibungen mit DCAT/DCAT-AP erzeugen.
- KI-geeignete Datensätze mit dem HammerHAI Data Management Service verknüpfen.
Automatisierte Datenaufbereitung
- Geeignete KI-Aufgaben identifizieren und die Eignung von Datensätzen für Machine Learning bewerten, insbesondere für Fertigungs- und Ingenieuranwendungen.
- Vorverarbeitungspipelines und wiederverwendbare Datenparser für industrielle Datensätze erstellen.
- Trainings- und Testdatensätze mit Strategien zur Vermeidung von Data Leakage erzeugen.
- Aufbereitete ML-Datensätze mit Croissant-Metadaten und Herkunftsinformationen bereitstellen.
Sichere agentenbasierte Verarbeitung von Rohdaten
- Private Datensätze lokal (On-Premises) in eingeschränkten Ausführungsumgebungen verarbeiten.
- KI-Agenten mit Anbindung an die SAIA-LLM-API zur automatisierten Analyse und Transformation einsetzen.
- Sensible Daten durch lokale Sandbox-Isolation und kontrollierte Zugriffsrechte schützen sowie Risiken durch Prompt Injection reduzieren.
- Verarbeitungsschritte dokumentieren, um Reproduzierbarkeit, Überprüfbarkeit und KI-Governance zu unterstützen.
Anwendungsbereiche
Der Dienst eignet sich insbesondere für Unternehmen aus Fertigung und Ingenieurwesen, deren bestehende Datensätze noch nicht unmittelbar für die KI-Entwicklung geeignet sind.
Typische Anwendungsfälle sind:
- Industrielle KI-Datenaufbereitung: Maschinen-, Sensor-, Produktions- und Qualitätsdaten in strukturierte und dokumentierte Datensätze für Machine Learning umwandeln.
- Verbesserung der Metadatenqualität: Unvollständige Metadaten ergänzen, um Auffindbarkeit, Interoperabilität und Wiederverwendbarkeit zu verbessern.
- Automatisierte ML-Vorbereitung: Manuellen Aufwand bei Vorverarbeitung, Aufgabendefinition und Erstellung von Trainings- und Testdatensätzen reduzieren.
- Bewertung der Dateneignung: Prüfen, ob vorhandene Industriedaten für Vorhersageaufgaben wie Predictive Maintenance oder Qualitätsprognosen geeignet sind.
- Reproduzierbare KI-Workflows: Datentransformationen, Datenherkunft und Datensatzstrukturen anhand maschinenlesbarer Standards dokumentieren.
So funktioniert es
HammerHAI stellt agentenbasierte Datenverarbeitungspipelines bereit, die lokal betrieben werden können und HammerHAI-Dienste zur LLM-Inferenz nutzen. Die Pipelines sind für Fertigungs- und Ingenieurdaten optimiert. Das HammerHAI-Team unterstützt bei der Anpassung an projektspezifische Anforderungen.
1. Datenzugriff und Analyse
- Datensätze aus bestehenden Data Lakes oder Datenkatalogen auswählen.
- Datenstrukturen, Metadatenqualität und mögliche industrielle KI-Anwendungen untersuchen.
2. Agentenbasierte Datenaufbereitung
- Geeignete Vorverarbeitungs- und Transformationsschritte automatisch identifizieren.
- Wiederverwendbare Parser und Trainings-/Testdatensätze unter Berücksichtigung von Data Leakage erzeugen.
- Datentransformationen in einer abgeschotteten Verarbeitungsumgebung ausführen.
3. Validierung und Metadatengenerierung
- Aufbereitete Datensätze validieren und ihre Eignung für KI-Aufgaben bewerten.
- Standardisierte Metadaten mit DCAT und MLCommons Croissant erstellen.
- Datenherkunft und Verarbeitungsschritte dokumentieren.
4. AI-readiness
- Aufbereitete Datensätze und wiederverwendbare Transformationspipelines bereitstellen.
- Integration mit HammerHAI Data Management zur Dokumentation und Wiederverwendung unterstützen.
Zugang
AI-Ready Data Engineering befindet sich derzeit in der Entwicklung und wird Unternehmen und Forschungsprojekten nach Möglichkeit (Best Effort) angeboten. Die Verfügbarkeit hängt von den Eigenschaften der Datensätze und den erforderlichen Verarbeitungskapazitäten ab.
Per E-Mail: Bitte senden Sie eine kurze Beschreibung Ihrer Datensätze und des geplanten KI-Anwendungsfalls an access@hammerhai.eu.
Angeboten von

Kontakt
Finanzierung
Der Dienst wird durch HammerHAI (European High Performance Computing Joint Undertaking, Fördervereinbarung Nr. 101234027) unterstützt.
Haftungsausschluss
Die automatisierte Datenaufbereitung und Metadatengenerierung erfordern eine fachliche Überprüfung. Die Ergebnisse hängen von der Qualität und den Eigenschaften der Eingangsdaten ab und können Halluzinationen enthalten.
Die Sicherheitsmaßnahmen der bereitgestellten Pipelines unterstützen Praktiken im Einklang mit ISO/IEC 27001, während Datendokumentation und Nachvollziehbarkeit die KI-Governance gemäß ISO/IEC 42001 unterstützen können. Diese Funktionen begründen für sich genommen keine Zertifizierung und garantieren keine vollständige Konformität mit den genannten Standards.